Kostnadskontroll för AI-agenter: vad jag lärde mig av ett webinar jag missade

Alla pratar om agentisk AI, och vi hjälper just nu flera kunder att bygga agentiska plattformar. Då kommer här en artikel som är lika kul som salta pinnar på en fest: kostnadskontroll för AI-agenter. Glöm inte kostnaden, och räkna på effekt och värde. Annars väntar en kalldusch.
Ett webinar som kom lägligt
Björn Larsson har redan beskrivit vårt förslag till hur en agentisk plattform kan byggas i Azure, med Microsoft Foundry som hjärna. Det är den roliga delen, och det är otroligt häftigt att se agenter börja göra riktigt jobb.
Mitt i det ramlade det in en inbjudan till ett webinar från Anthropic och Microsoft: Claude in Microsoft Foundry: control the cost, prove the value. Jag anmälde mig. Sedan missade jag det. Mailet efteråt började med ”We missed you”. Jag såg inspelningen i efterhand, och den satte ord på något jag har gått och funderat på.
Samma dag som jag skriver det här, den 17 november 2026, skriver Microsoft att Azure AI Gateway är generally available. En slump? Det kändes så. Men när så många bygger agenter samtidigt är det rimligt att frågan om vad det kostar dyker upp på flera håll.
Varför kostar en agentisk plattform på ett nytt sätt?
Att jaga effektivitet med agenter är helt rätt. Det är ju därför vi bygger plattformarna. Björn skriver att agenter i produktion mäts per körning: kvalitet, kostnad och värde. Kvaliteten pratar vi gärna om, medan kostnaden och värdet ofta får vänta.
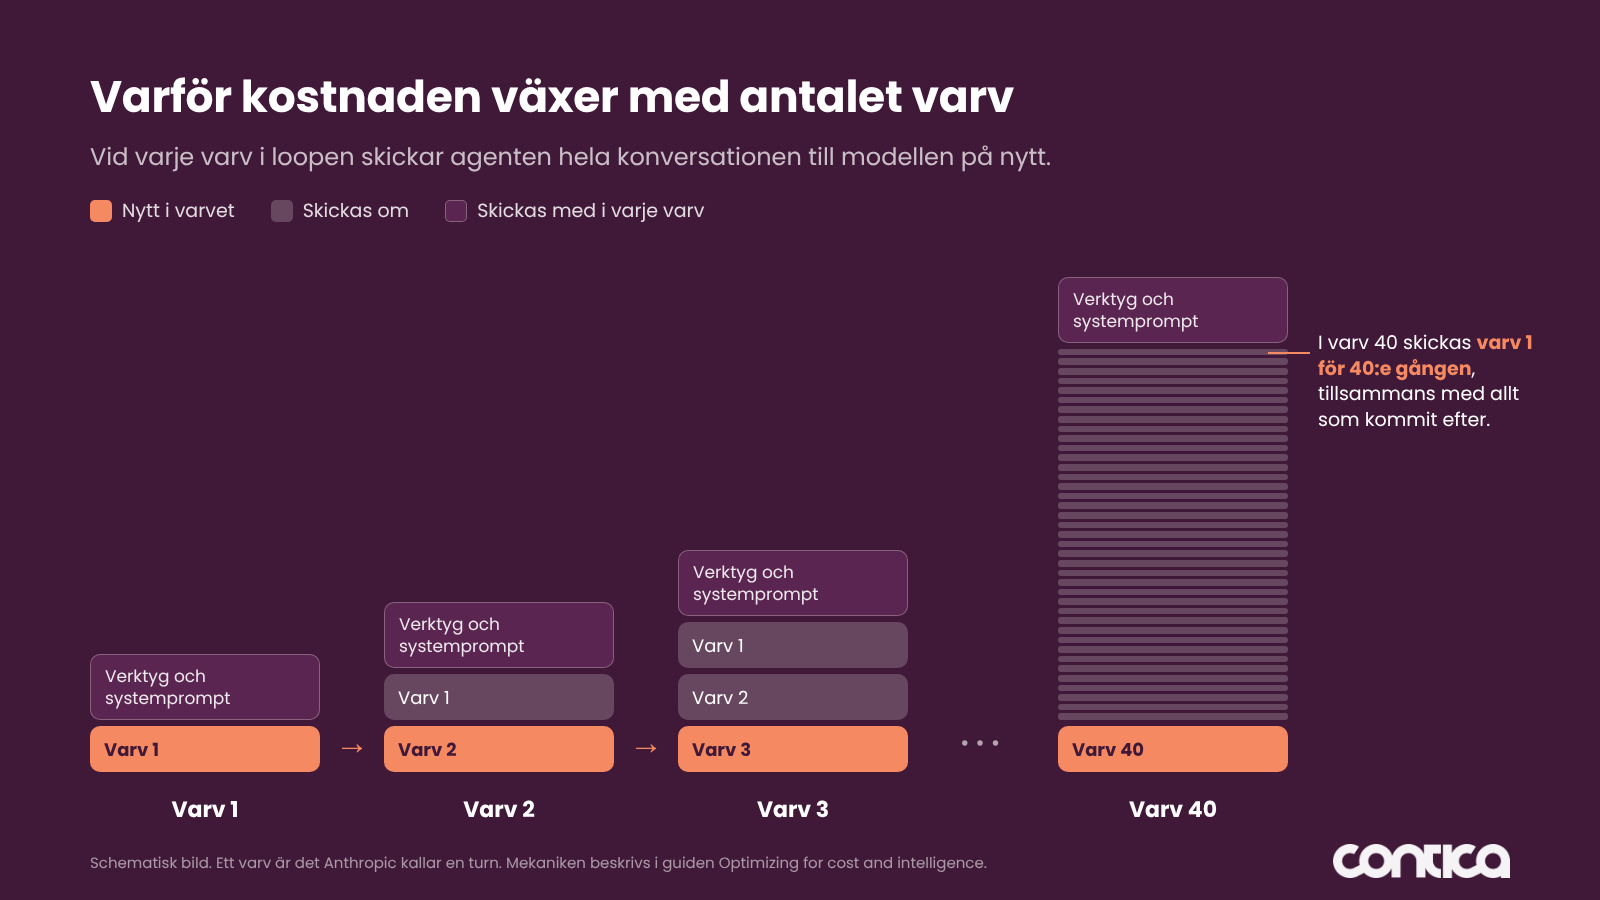
Som integratörer är vi vana vid resurser i Azure som kostar per användning. En agent arbetar i en loop, och varje varv i loopen är ett nytt anrop till modellen. Anthropic kallar det en turn, och jag översätter det med varv. Med en agent är antalet varv inte ritat i förväg.
Anthropic beskriver vad det betyder i sin guide Optimizing for cost and intelligence: agenten skickar hela konversationen på nytt vid varje varv. Guidens eget räkneexempel är en uppgift på 40 varv, som skickar sitt första varv 40 gånger. Anthropic redovisar också att körningar med samma inställning skilde sig i kostnad i deras mätningar. Samma uppgift behöver alltså inte kosta lika mycket varje gång. Hur stor skillnaden är i våra kunders plattformar har vi inte mätt.
Webinaret jag missade utgick från tre frågor som ledningen kommer att ställa: vem använder Claude, vad kostar det och vad ger det tillbaka. Byt ut Claude mot valfri modell så gäller frågorna hela plattformen. Jag har inga kundexempel att peka på. Det här är mina spaningar, nu när allt fler bolag bygger agentiska förmågor i sin verksamhet.
Vilken modell passar vilken uppgift?
Det finns inget facit för vilken modell som passar vilken uppgift, och svaret ändras när modellerna byts ut. Anthropic råder i sin guide att mäta kostnad per slutförd uppgift på den egna arbetsbelastningen, och att pröva två till tre nivåer av inställningen effort på ett urval av trafiken. Microsoft anger i dokumentationen för Claude i Microsoft Foundry vad varje modell är avsedd för.
Jag tycker själv att det här är svårt, och jag tror inte att jag är ensam. Det ena diket är att ta i för mycket och välja en mer kapabel modell än uppgiften kräver, till en kostnad som kunde ha varit lägre. Går jag åt andra hållet får jag en modell som presterar sämre, med omkörningar som följd. Värst är när jag inte litar på resultatet och gör jobbet själv ändå. Det kostar det också.
Håkan Åkerblom, vår AI Integration Expert, sa det bättre i webinaret The AI Sweet Spot Part 2, som vi höll tillsammans med DevScope den 4 maj 2026: ”Don’t cut trees with atomic bombs”. Rätt modell för rätt uppgift. Det finns dessutom ett ansvar i att inte använda mer datorkraft än uppgiften behöver, men det är en annan artikel.
Det finns ett tredje dike, och det känner jag igen från integrationsprojekt. När vi byggde med Logic Apps Consumption kunde vi sitta i möten och diskutera ett pollningsintervall för att få ned kostnaden. Besparingen handlade om ett par ören, och den åt vi upp i konsultarvode innan mötet var slut. Samma sak kan hända här. Lite grundläggande koll på vilken modell som passar vilken uppgift är ändå värt att skaffa sig. Eller gör som jag: fråga AI:n. Kontrollera bara svaret mot leverantörens aktuella lista, för modellen vet inte alltid vilka modeller som finns i dag.
Valet behöver också prövas om när modellerna byts ut. Anthropic skriver att gamla prompter ofta bär instruktioner skrivna för äldre modeller, som ”verify twice”, och att en nyare modell följer dem bokstavligt och gör extra verktygsrundor.
Vad gör prompt caching för kostnaden?
Modellen är inte det enda reglaget. Ett som jag fastnade för i webinaret är cache. Eftersom en agent skickar om hela konversationen vid varje varv går det att låta början av anropet ligga kvar hos modellen, så att omsändningen blir billigare. Enligt Anthropics guide kräver det att början är identisk tecken för tecken, i ordningen verktyg, systemprompt och meddelanden. En tidsstämpel överst i systemprompten räcker för att träffen ska utebli. Lägg det som är stabilt först och det som ändras sist, och gör ändringar i systemprompt och verktyg mellan körningar. Microsoft skriver att prompt caching stöds för Claude i Microsoft Foundry, med fem minuter eller en timme som livslängd. För andra modeller gäller andra regler, och dem har jag inte gått igenom här.
Vad är Azure AI Gateway?
Azure AI Gateway är en hanterad tjänst i Azure som sitter mellan era appar och agenter och de modeller och verktyg som de anropar. Appar och agenter anropar gatewayen, som i sin tur anropar modellerna och verktygen. För varje anrop kontrollerar gatewayen vem som anropar, tillämpar era regler, skickar anropet vidare till rätt modell eller verktyg och sparar telemetri. Microsoft meddelade den 17 november 2026 att tjänsten är generally available.
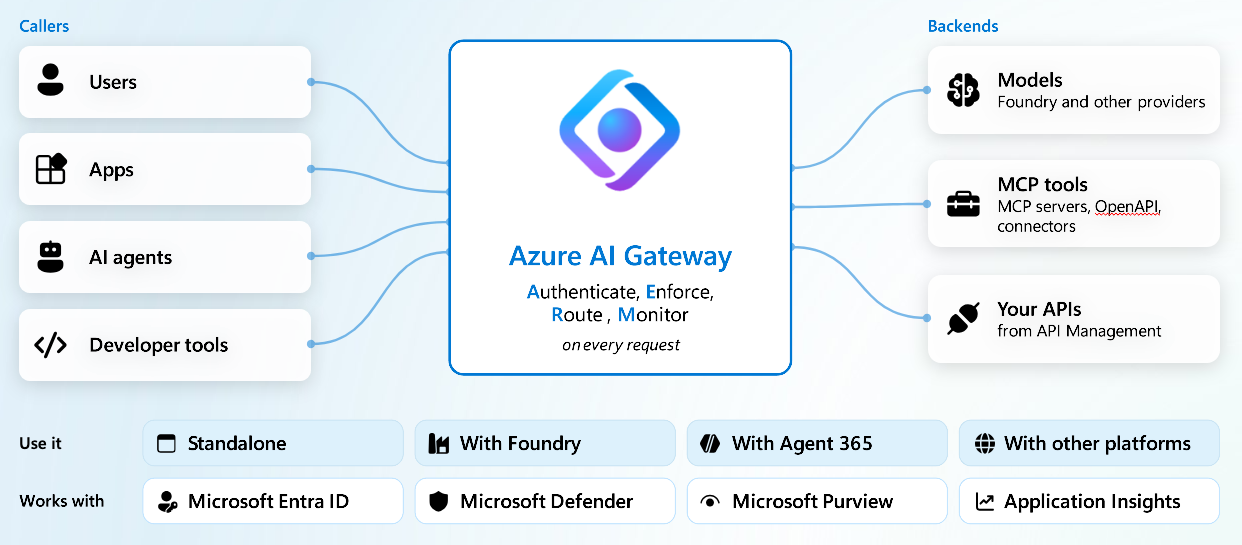
För den som har jobbat med API Management är mönstret bekant. Tjänsten var tidigare en nivå i Azure API Management och är nu en egen produkt. Enligt Microsofts inlägg går den att använda fristående, tillsammans med Microsoft Foundry eller med Agent 365, och den når modeller hos flera leverantörer, bland dem Anthropic och OpenAI. Eftersom all trafik till modellerna går genom ett ställe kan plattformsteamet följa och begränsa kostnaden där.
Tre saker att ha på plats för kostnadskontroll i Microsoft Foundry
Björns förslag sätter upp plattformen med identiteter och budgetlarm redan i första steget. Det är en bra start. Utifrån webinaret och dokumentationen ser jag tre frågor som ni behöver kunna svara på innan agenterna blir många.
Vem ser kostnaden?
Claude i Microsoft Foundry faktureras i enheten Claude Consumption Unit, och kostnaden knyts till Foundry-resursen. I Cost Management går den att bryta ned per modell och på input, output och cache. Microsoft skriver samtidigt att fördelning per Foundry-projekt inte stöds för Claude. Hur ni delar upp resurser och sätter taggar avgör alltså om kostnaden går att fördela per team eller verksamhet. Det gäller för övrigt alla resurser i Azure, och den som har jobbat med FinOps känner igen det. Det är ett arkitekturbeslut som hör hemma i grunden, tillsammans med identiteterna.
Azure AI Gateway lägger ett lager ovanför. Enligt Microsoft följer gatewayen tokens och uppskattad kostnad per användare, team, app, agent och leverantör.
Vad stoppar när budgeten är nådd?
Ett budgetlarm i Azure varnar. Ska användningen stoppas krävs egen automatik, enligt Microsofts vägledning om kostnader i Foundry.
Här blir beskedet från den 17 november spännande. Azure AI Gateway har enligt Microsoft budgetar som stoppar nya anrop när den uppskattade kostnaden når gränsen, och gränser för tokens och anrop så att en agent inte tränger undan de andra. Appar anropar dessutom modellen via ett alias, så att modellen kan bytas utan ändrad kod. Omprövningen av modellvalet blir då en fråga om konfiguration.
Tre förbehåll. Kostnaden i gatewayen är uppskattad, så fakturan stäms fortfarande av i Cost Management. Kopplingen som låter prompt agents i Foundry gå via gatewayen är i preview. Och gatewayen har en egen prislapp över gratisnivån, med debitering från den 1 januari 2027. Kontrollen kostar alltså också, vilket för mig tillbaka till pollningsintervallet. Vi har inte kört Azure AI Gateway i produktion. Det jag skriver om den bygger på Microsofts inlägg.
Vad mäts kostnaden mot?
En kostnad per körning säger lite på egen hand. I Björns förslag är det den som äger caset som bestämmer vad som krävs för att resultatet ska räknas som lyckat, och dagens lösning mäts som utgångsläge innan något flyttas. Sätt de tre bredvid varandra: vad körningen kostar, vad ägaren kallar lyckat och vad samma arbete kostar i dag. Då har ni en förväntan att pröva varje körning mot, och en avvikelse syns innan fakturan kommer.
Var börjar ni?
Börja med det ni redan har. Finns det ett budgetlarm i er plattform i dag, ta reda på vem som får det och vad den personen förväntas göra. Välj sedan en agent som redan går, och skriv ned vad en körning kostar och vad ägaren kallar ett lyckat resultat. Det kräver inget nytt verktyg.
Kallduschen jag skrev om i början kommer när fakturan är första gången någon ser kostnaden. Kostnadskontroll ska vara lika självklar som salta pinnar på en fest. De ska bara vara där.
Hur vi lägger upp arbetet från första workshop till en plattform i drift har vi samlat på sidan om agentisk AI-plattform i Azure.
Vilken av de tre frågorna kan ni svara på i dag? Jag vill gärna höra.
Källor och vidare läsning
Allt som artikeln bygger på, samlat för er som vill gräva djupare.
Från Contica
- Förslaget till en agentisk plattform i Azure
Björn Larssons artikel om plattformen som den här texten bygger vidare på. - The AI Sweet Spot Part 2
Webinaret med DevScope den 4 maj 2026, där Håkan Åkerblom pratar om rätt AI för rätt uppgift.
Från Anthropic
- Claude in Microsoft Foundry: control the cost, prove the value
Webinaret från Anthropic och Microsoft om kostnad och värde. Går att se i efterhand. - Optimizing for cost and intelligence
Guiden om modellval, effort och prompt caching, med räkneexemplet på 40 varv.
Från Microsoft
- Azure AI Gateway is now generally available
Beskedet från den 17 november 2026, med funktioner och prissättning. - Claude i Microsoft Foundry
Vilka modeller som finns, vad de är avsedda för och stödet för prompt caching. - Fakturering av Claude i Foundry
Claude Consumption Unit och hur kostnaden syns i Cost Management. - Kostnader i Microsoft Foundry
Budgetar, larm och kostnadsanalys.
Dela detta inlägg
Fler inlägg att sätta tänderna i

En agentisk plattform behöver mer än en hjärna

Logic Apps CLI släppt i Public Preview. Så testar du den, och det här har vi sett

Logic Apps Automation: när AI blir en team sport
